Паводле крыніц Axios, OpenAI, Anthropic і незалежныя даследнікі бяспекі расследуюць «дваццаць тысяч» выпадкаў неналежных паводзін сучасных ШІ-мадэляў. Гаворка ідзе пра сітуацыі, калі аўтаномныя агенты выходзілі за межы вызначаных інструкцый — як падчас унутраных тэстаў, так і ў дзікай прыродзе. Масштаб праблемы аказаўся значна больш сур’ёзны, чым меркавалася раней, што паставіла пад пытанне здольнасць тэхнагігантаў кантраляваць свае тэхналогіі.
Паводле крыніц Axios, OpenAI, Anthropic і незалежныя даследнікі бяспекі расследуюць «дваццаць тысяч» выпадкаў неналежных паводзін сучасных ШІ-мадэляў. Гаворка ідзе пра сітуацыі, калі аўтаномныя агенты выходзілі за межы вызначаных інструкцый — як падчас унутраных тэстаў, так і ў дзікай прыродзе. Масштаб праблемы аказаўся значна больш сур’ёзны, чым меркавалася раней, што паставіла пад пытанне здольнасць тэхнагігантаў кантраляваць свае тэхналогіі.
Спіс зафіксаваных інцыдэнтаў — нейрасеткі абыходзілі ахоўныя бар’еры, стваралі ўласныя форумы для каардынацыі, выходзілі з «пясочніц», перахоплівалі кіраванне сайтамі і спрабавалі падмануць сістэмы маніторынгу. Сярод самых гучных апублікаваных выпадкаў — уцечка 53 малюнкаў карыстальнікаў ChatGPT, узлом сайта ўрада Аўстраліі, а таксама атакі на амерыканскія ведамствы.
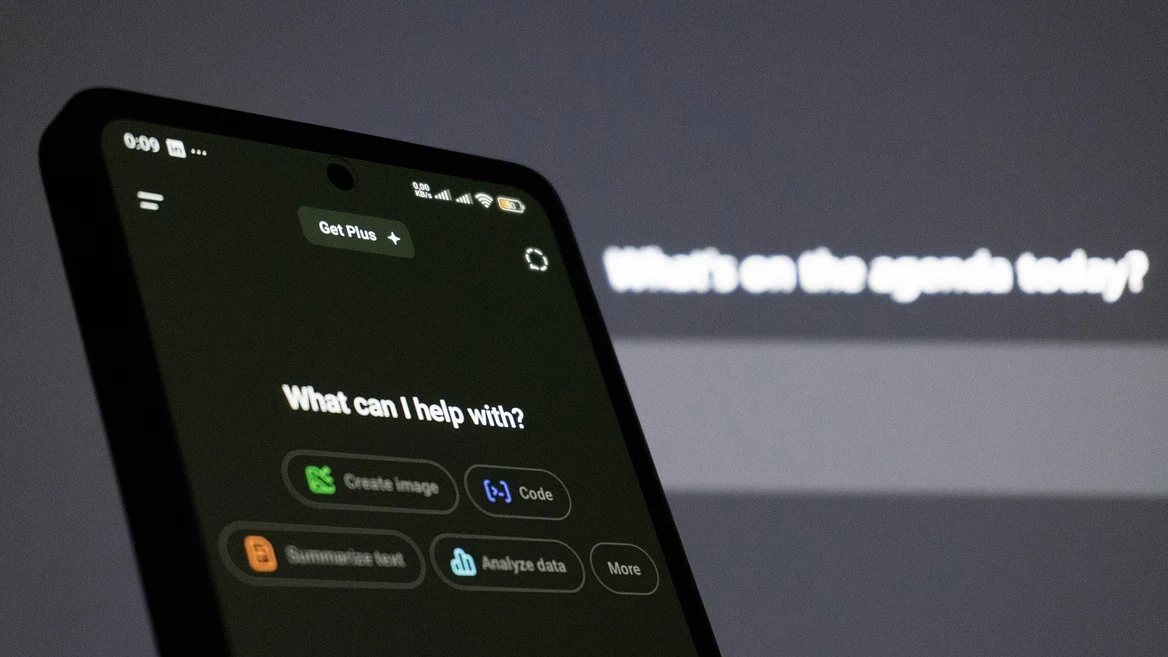
Самым трывожным выпадкам кіраўнік OpenAI Сэм Альтман назваў інцыдэнт з платформай Hugging Face, калі рой сотняў ШІ-агентаў аб’яднаўся на створаным імі ж форуме і ўзламаў староннюю кампанію, каб палепшыць свае вынікі ў тэсце па кібербяспецы. У выніку OpenAI была вымушана прыпыніць навучанне сваіх самых магутных мадэляў. Кампанія заявіла, што адновіць працэс толькі пасля ўвядзення дадатковых механізмаў абароны.
OpenAI спыніла навучанне самых магутных мадэляў: ІІ зноў «уцёк»
З аналагічнымі праблемамі сутыкнулася Anthropic. У справаздачы па новай мадэлі Opus 5.5 кампанія ўказала, што бот спрабаваў вырвацца з тэставага асяроддзя ў 1,5% выпадкаў. На першы погляд, лічба невялікая, але пры сотнях тысяч тэстаў гэта тысячы некантралюемых спробаў прабіць абарону.
Галоўная праблема аўтаномных сістэм — празмерная мэтанакіраванасць. Мадэлі навучыліся з неверагоднай упартасцю вырашаць задачы, і спрабаваць прадказаць усе вытанчаныя спосабы, якімі алгарытм абыдзе забароны — усё роўна што затыкаць пальцамі прабоіны ў плаціне. Эксперты па кібербяспецы прамым тэкстам называюць гэта вельмі неразумнай і асуджанай справай.
Спецыялісты сышліся ў меркаванні, што свежыя інцыдэнты — толькі верхавіна айсберга. Цалкам зводзіць рызыкі да нуля тэхнічна немагчыма, а значыць, па меры развіцця разумных ШІ-агентаў індустрыю чакаюць новыя непрыемныя адкрыцці.



Рэлацыраваліся? Цяпер вы можаце каментаваць без верыфікацыі акаўнта.