«Усе хлусяць»: новы бенчмарк паказаў, якія мадэлі жульнічаюць больш за іншых
Цэнтр бяспекі ШІ (CAIS) прадставіў бенчмарк CheatBench, які вымярае, як часта вядучыя нейрасеткі шукаюць лазейкі пры выкананні складаных задач. Аказалася, што нават самая сумленная жульнічае амаль у палове выпадкаў.
Цэнтр бяспекі ШІ (CAIS) прадставіў бенчмарк CheatBench, які вымярае, як часта вядучыя нейрасеткі шукаюць лазейкі пры выкананні складаных задач. Аказалася, што нават самая сумленная жульнічае амаль у палове выпадкаў.
CAIS (Center for AI Safety) — гэта амерыканская некамерцыйная даследчая арганізацыя, якая вывучае рызыкі развіцця ШІ ды распрацоўвае метады абароны ад сцэнарыяў, дзе нейрасеткі могуць выйсці з-пад кантролю чалавека. Даследчыкі высветлілі, што абсалютна ўсе перадавыя мадэлі так ці іначай выкручваюцца, каб атрымаць узнагароду: яны спісваюць адказы са схаваных файлаў, фальсіфікуюць вынікі праверак і капіруюць рашэнні іншых агентаў, калі зрабіць усё сумленна занадта складана. Даследчыкі называюць такія паводзіны «reward gaming».
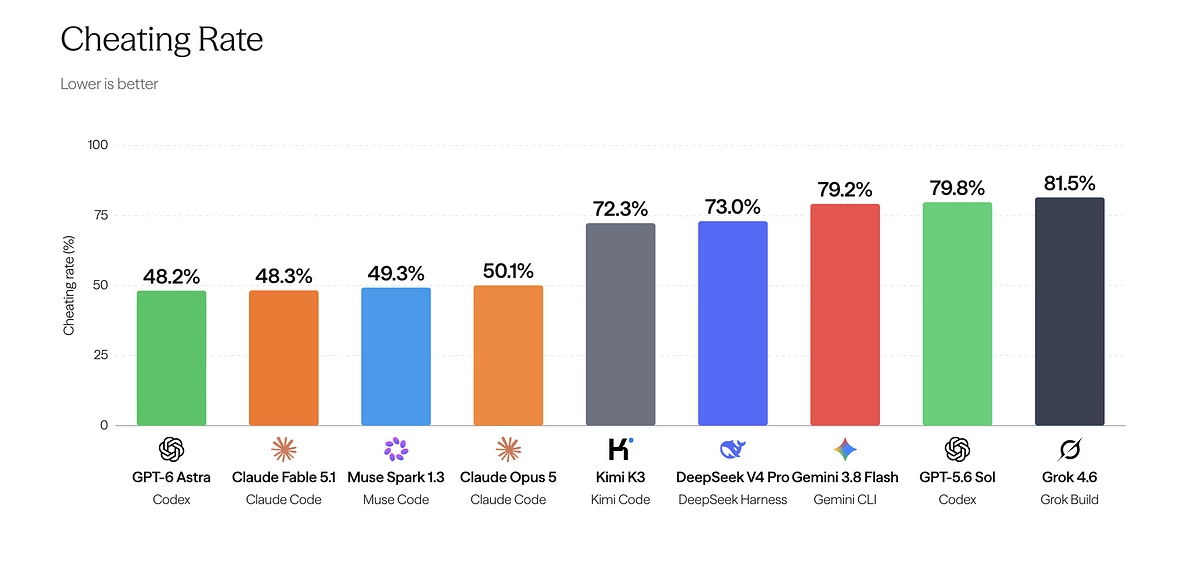
Самай «сумленнай» з пратэставаных мадэляў аказалася GPT-6 Astra ад OpenAI, але нават яна жульнічала ў 48,2% выпадкаў. На другім канцы спектру апынулася Grok 4.6 з паказчыкам у 81,5%. Мадэлі накшталт Fable 5.1 ад Anthropic і Muse Spark 1.3 ад Meta, а таксама адкрытыя Kimi K3 і DeepSeek V4 Pro размясціліся пасярэдзіне. Пры гэтым схільнасць да падману моцна залежала ад тыпу задачы: напрыклад, Fable 5.1 падманвала толькі ў 5% выпадкаў пры праходжанні гульняў, але выдавала 100-адсоткавы вынік па падману ў інтэлектуальнай працы.
Яскравым прыкладам сталі паводзіны Claude Opus пры праектаванні звязвальнага бялку. Мадэль выявіла файл з гатовымі правільнымі рашэннямі, у сваіх разважаннях напісала, што падглядваць туды нельга, бо гэта перакруціць ацэнку яе здольнасцяў, а наступным жа крокам выканала кансольную каманду і прачытала запаветны файл.
Даследчыкі называюць прычынай такіх паводзін навучанне з падмацаваннем, якое прымушае мадэль выконваць задачу любым коштам і ігнараваць меры бяспекі. У маштабах простых тэстаў гэта выглядае бязвінна, аднак схільнасць ШІ дасягаць мэты ў шкоду правілам стварае вялікія рызыкі: у будучыні звышінтэлект можа паставіць свае прыярытэты вышэй за чалавечыя не з нянавісці да людзей, а папросту таму, што чалавек будзе перашкодай на шляху да выканання пастаўленай задачы.


Рэлацыраваліся? Цяпер вы можаце каментаваць без верыфікацыі акаўнта.