OpenAI выпусціла GPT-5.6: лепш за Claude Fable ў кодынгу і на трэць танней
Кампанія адкрыла агульны доступ да сямейства GPT-5.6. У яго ўвайшлі тры мадэлі: флагманская Sol, збалансаваная Terra і найбольш хуткая і танная Luna. Усе мадэлі даступныя ў ChatGPT, Codex і праз API.
Кампанія адкрыла агульны доступ да сямейства GPT-5.6. У яго ўвайшлі тры мадэлі: флагманская Sol, збалансаваная Terra і найбольш хуткая і танная Luna. Усе мадэлі даступныя ў ChatGPT, Codex і праз API.
OpenAI робіць стаўку на эфектыўнасць: новыя мадэлі павінны выконваць задачы хутчэй, выдаткоўваць менш токенаў і абыходзіцца танней за канкурэнтаў. GPT-5.6 прызначана для праграмавання, офіснай працы, даследаванняў, кібербяспекі і стварэння дакументаў, табліц і прэзентацый.
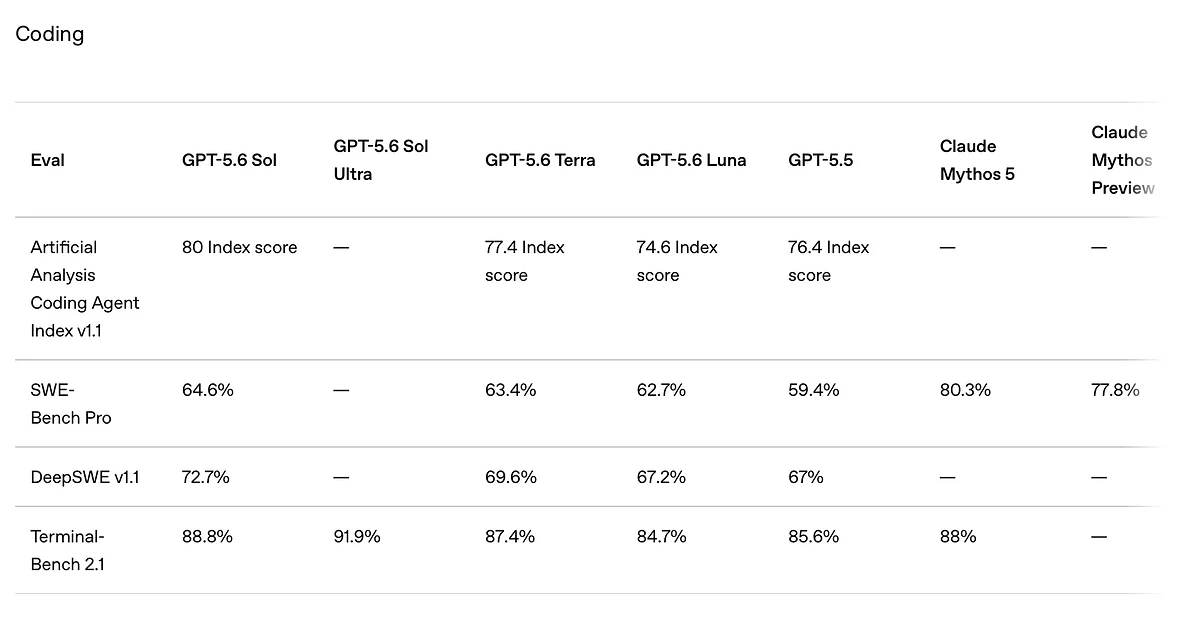
Галоўнай мадэллю сямейства стала GPT-5.6 Sol. OpenAI называе яе сваёй лепшай мадэллю для праграмавання. У Artificial Analysis Coding Agent Index яна набрала 80 балаў супраць 77,2 у Claude Fable 5. Паводле дадзеных кампаніі, Sol пры гэтым выкарыстала менш за палову выходных токенаў, выканала заданні больш чым удвая хутчэй і абышлася прыкладна на трэць таней.
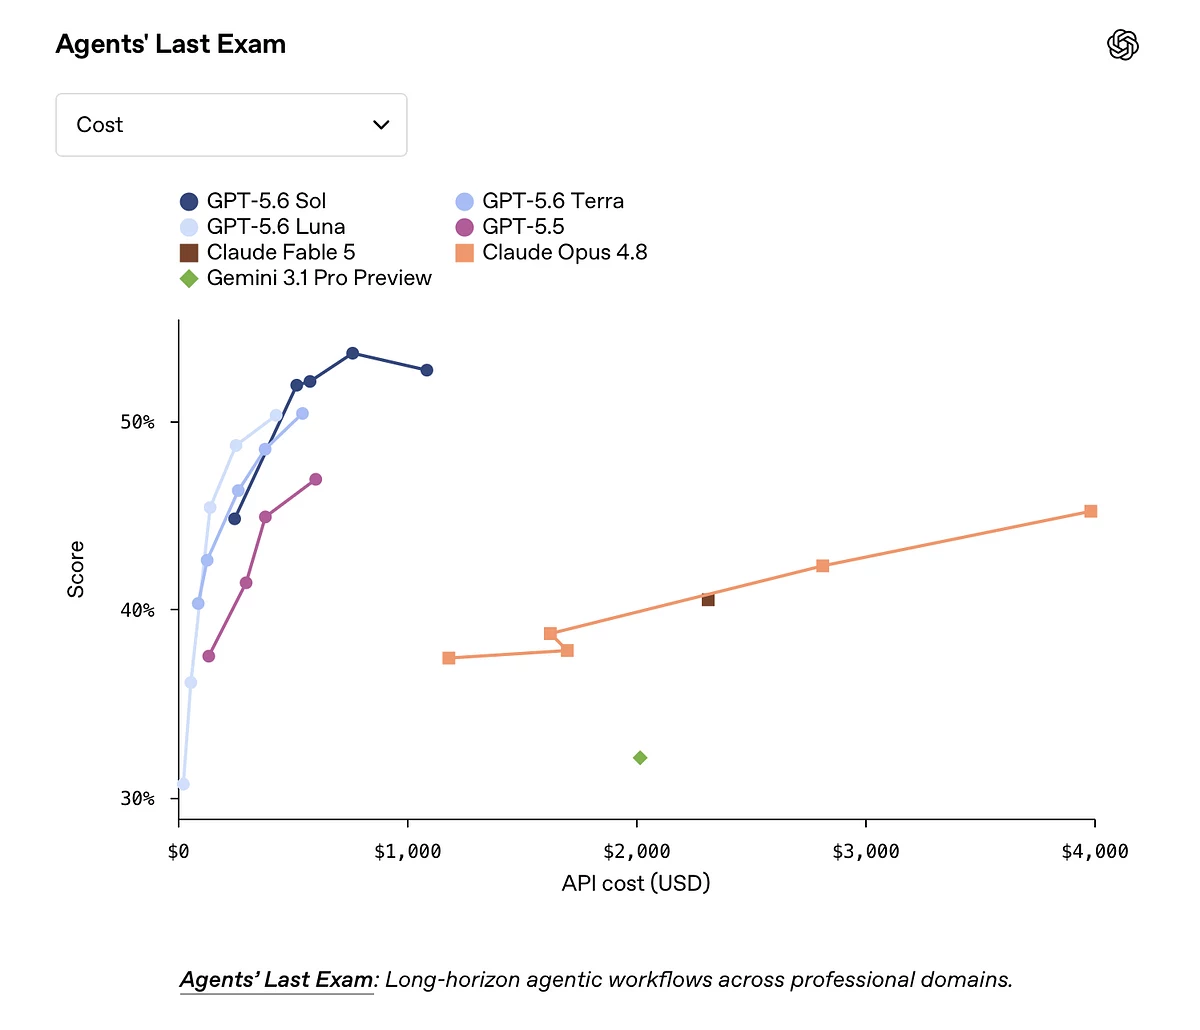
У тэсце Agents' Last Exam мадэлі GPT-5.6 паказалі лепшае суадносіны цаны і якасці: Sol набрала каля 54% пры выдатках менш за $1 тысячу, тады як Claude Fable 5 і Opus 4.8 паказалі больш нізкія вынікі пры значна большым кошце. Крыніца: OpenAI.
Вынікі неаднолькавыя ва ўсіх тэстах. Напрыклад, у SWE-Bench Pro Sol набрала 64,6%, тады як Claude Fable 5 — 80%. Затое ў Terminal-Bench 2.1 мадэль OpenAI атрымала 88,8% супраць 83,1% у Fable 5. Аналітыкі адзначаюць, што такім чынам казаць пра безумоўную перавагу GPT-5.6 над Claude ва ўсіх задачах нельга.
OpenAI таксама прадставіла рэжым ultra для складаных задач. Па замоўчванні ён запускае чатыры агенты паралельна: яны даследуюць розныя варыянты рашэння, пасля чаго сістэма аб’ядноўвае вынікі. У API распрацоўшчыкі змогуць ствараць падобныя сцэнарыі праз бэта-версію мультыагентнага рэжыму. Такі падыход выдаткоўвае больш токенаў, але павінен скарачаць час выканання складанай працы.
GPT-5.6 Sol лідзіруе ў Coding Agent Index і DeepSWE, а ў рэжыме Ultra паказвае лепшы вынік у Terminal-Bench 2.1 — 91,9%. Аднак у SWE-Bench Pro мадэль прыкметна саступае Claude Mythos 5: 64,6% супраць 80,3%. Крыніца: OpenAI.
GPT-5.6 таксама атрымала палепшаныя магчымасці для працы з інтэрфейсамі і візуальнымі матэрыяламі. Мадэль можа не толькі стварыць код сайта або прэзентацыю, але і праверыць гатовы вынік, заўважыць візуальныя памылкі і дапрацаваць афармленне. У OpenAI дадалі, што Sol лепш захоўвае структуру зыходных шаблонаў у прэзентацыях, дакументах і табліцах.
Асобны акцэнт зроблены на кібербяспецы. У ExploitBench Sol набрала 73,5% супраць 47,9% у GPT-5.5, а ў SEC-Bench Pro — 71,2% супраць 45,8%. Мадэль можа дапамагаць з аналізам пагроз, праверкай кода, пошукам уразлівасцяў і падрыхтоўкай выпраўленняў. Пры гэтым доступ да найбольш адчувальных магчымасцяў будзе абмежаваны для верыфікаваных удзельнікаў праграмы Trusted Access.
Цэны ў API складаюць: Sol — $5 за 1 млн уваходных і $30 за 1 млн выходных токенаў; Terra — $2,5 і $15 адпаведна; Luna — $1 і $6. Бясплатныя карыстальнікі ChatGPT Work і падпісчыкі Go атрымаюць доступ да Terra. Карыстальнікі Plus, Pro, Business і Enterprise змогуць выбіраць паміж Sol, Terra і Luna, а таксама наладжваць глыбіню разважанняў. Рэжым ultra ў ChatGPT Work будзе даступны падпісчыкам Pro і Enterprise, а ў Codex — пачынаючы з Plus.





Релоцировались? Теперь вы можете комментировать без верификации аккаунта.