
OpenAI стварыла «фабрыку» ШІ-агентаў, каб ChatGPT не тармазіў
Кампанія стварыла Performance Factory — сістэму ШІ-агентаў на базе Codex, якая аўтаматычна расследуе запаволенні ChatGPT і прапануе выпраўленні.
Кампанія стварыла Performance Factory — сістэму ШІ-агентаў на базе Codex, якая аўтаматычна расследуе запаволенні ChatGPT і прапануе выпраўленні.
Кампанія стварыла Performance Factory — сістэму ШІ-агентаў на базе Codex, якая аўтаматычна расследуе запаволенні ChatGPT і прапануе выпраўленні.
Раней інжынеры OpenAI самастойна вывучалі логі, адсочвалі змены ў кодзе і шукалі прычыны запаволення сервісаў. Цяпер значную частку гэтай працы выконваюць ШІ-агенты.
Performance Factory працуе аўтаматычна. Калі сістэма маніторынгу выяўляе падзенне прадукцыйнасці, яна стварае задачу для Codex. Агент аналізуе паказчыкі, правярае журналы падзей і змены ў кодзе, пасля чаго спрабуе выявіць прычыну праблемы.
Аднак OpenAI выявіла, што ШІ часам спыняецца на першым праўдападобным тлумачэнні, нават калі доказаў недастаткова. Таму кампанія дадала яшчэ аднаго агента, які пераправерае высновы першага.
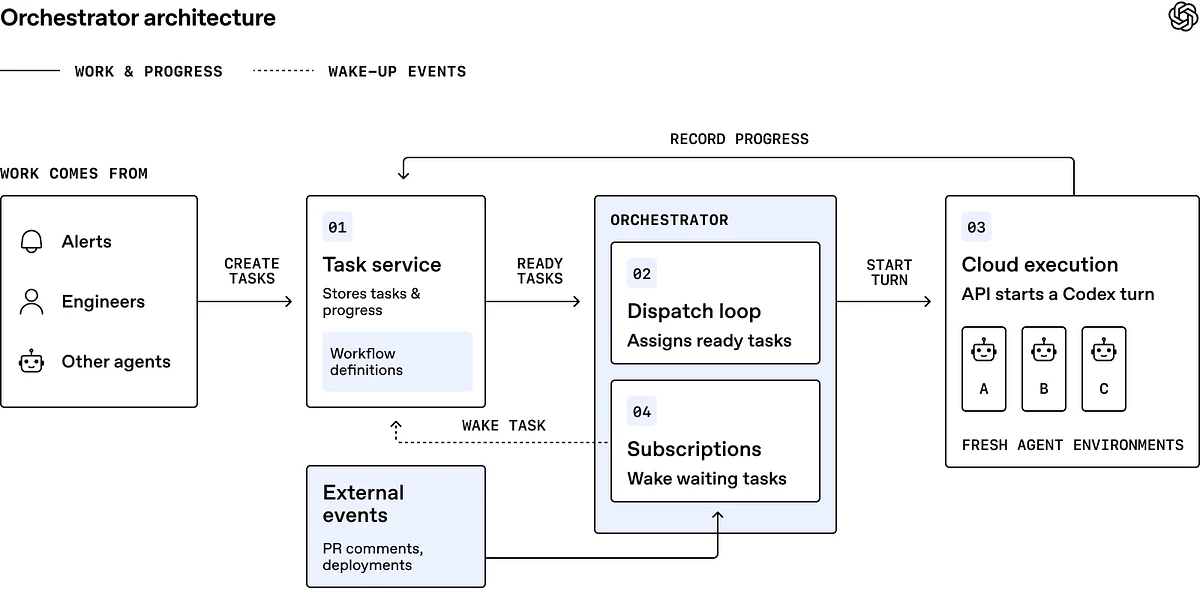
Другі Codex атрымлівае вынікі расследавання, але пачынае працу з чыстым кантэкстам. Яго задача — знайсці памылкі ў першапачатковай версіі і праверыць альтэрнатыўныя тлумачэнні. Цяпер прыкладна чвэрць дыягназаў адпраўляецца на паўторнае расследаванне.
Напрыклад, аднойчы агент звязаў збоі ў размовах ChatGPT з памылкамі загрузкі выяваў. Аднак той, хто правяраў, заўважыў, што сервіс пошуку файлаў ужо аднавіўся, а праблемы з выявамі працягваліся. У выніку расследаванне прыйшлося аднавіць.
Калі праверка пройдзена, Codex прапануе выпраўленне і стварае пул-рэквест. Інжынер вывучае змены і вырашае, ці можна іх прыняць. Пасля разгортвання выпраўлення яшчэ адзін агент правярае, ці сапраўды праблема знікла.
За тры з лішнім месяцы сістэма правяла больш за 1700 расследаванняў — у сярэднім каля 17 на дзень. Больш чым у 600 выпадках удалося выявіць прычыну праблемы, а прыкладна ў 400 агенты падрыхтавалі прапановы па выпраўленні.
Але з укараненнем зменаў вынікі пакуль сціплейшыя. Паводле дадзеных OpenAI, каля 50 выпушчаных выпраўленняў былі заснаваныя на прапановах агентаў або супадалі з імі. Прыкладна 15 выпраўленняў былі ўкаранёныя непасрэдна ў выглядзе пул-рэквестаў, створаных Codex.
У кампаніі прызнаюць, што сістэма пакуль лепш справляецца з дыягностыкай, чым з самастойным выпраўленнем памылак. Асабліва добра агенты працуюць з адносна простымі праблемамі, напрыклад калі код паўторна выконвае непатрэбныя аперацыі.
Складаныя архітэктурныя змены даюцца ім горш. Часам прапанаваныя выпраўленні ствараюць новыя праблемы: напрыклад, даданне кэша паскарае адказы, але прыводзіць да выкарыстання састарэлых дадзеных. Таму OpenAI ўкараніла дадатковую праверку і для прапанаваных зменаў.
У будучыні кампанія хоча навучыць агентаў самастойна шукаць запаволенні, якія не выяўляюць звычайныя сістэмы маніторынгу. OpenAI таксама разглядае магчымасць дазволіць ім укараняць некаторыя выпраўленні з нізкім узроўнем рызыкі без узгаднення з чалавекам.




Релоцировались? Теперь вы можете комментировать без верификации аккаунта.