Не ведаеш англійскай? Запыты да ШІ на іншых мовах абыходзяцца ў разы даражэй
Кошт працы з ШІ залежыць не толькі ад мадэлі, але і ад мовы запыту. Некаторыя мовы патрабуюць значна больш токенаў, што павялічвае выдаткі і скарачае аб’ём інфармацыі, даступнай для апрацоўкі.
Кошт працы з ШІ залежыць не толькі ад мадэлі, але і ад мовы запыту. Некаторыя мовы патрабуюць значна больш токенаў, што павялічвае выдаткі і скарачае аб’ём інфармацыі, даступнай для апрацоўкі.
Да такой высновы прыйшлі даследчыкі суполкі Coalition for Language Equity in AI Research (CLEAR), якія параўналі апрацоўку тэкстаў прыблізна на 200 мовах. Розніцу яны назвалі схаваным «падаткам на токены».
Праблема звязаная з токенізацыяй — працэсам, пры якім ШІ разбівае тэкст на невялікія фрагменты перад апрацоўкай. Токен можа адпавядаць цэламу слову, яго частцы або нават асобнаму байту. Чым менш эфектыўна мадэль апрацоўвае мову, тым больш токенаў трэба для перадачы аднаго і таго ж сэнсу.
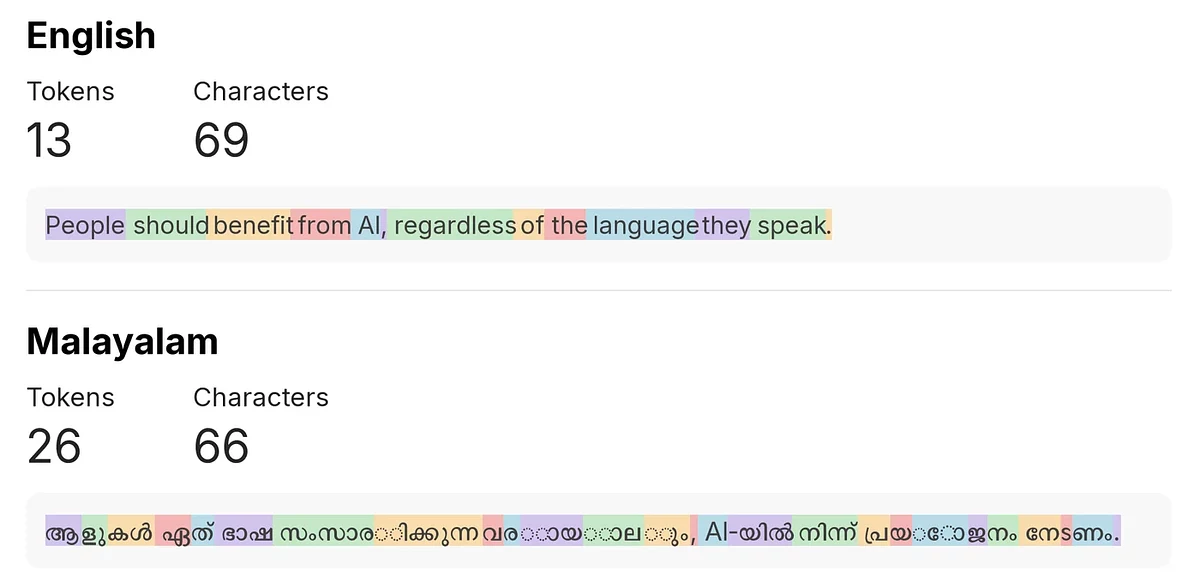
Напрыклад, фраза «Людзі павінны атрымліваць карысць ад ШІ незалежна ад таго, на якой мове яны гавораць» на англійскай займае ў GPT-5 усяго 13 токенаў. Яе пераклад на мову жыхароў Індыі малаялам патрабуе 26 токенаў, а на амхарскую (на ёй гавораць у Эфіопіі) — ужо 78. Такім чынам, апошні варыянт абыходзіцца ў шэсць разоў даражэй пры аплаце ўваходных токенаў паводле аднолькавага тарыфу.
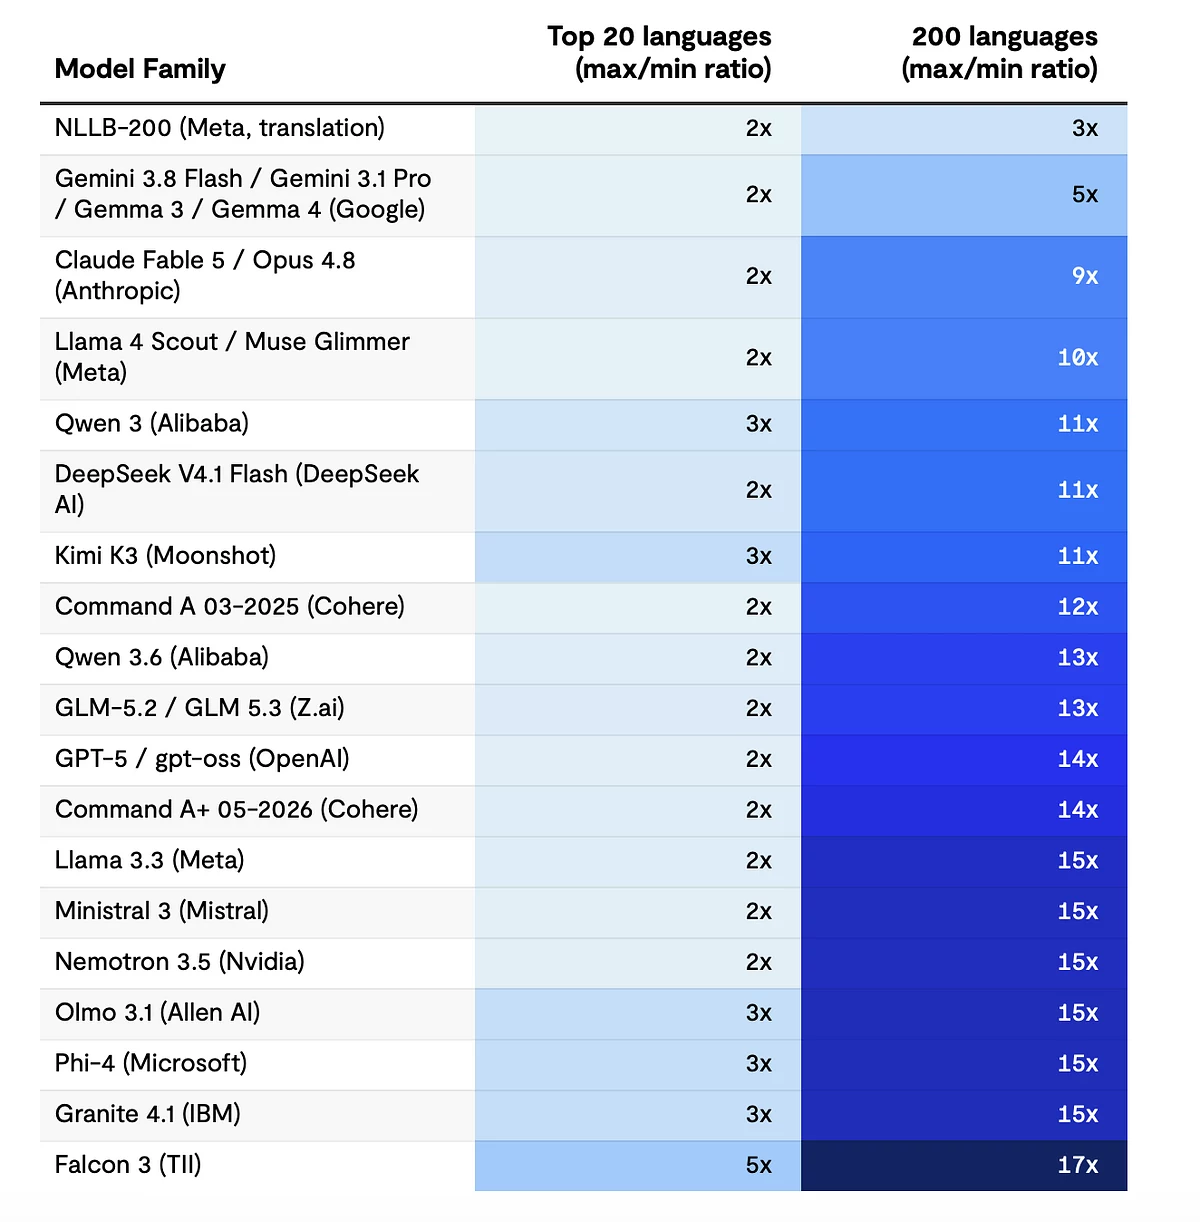
Розніца ў колькасці токенаў для аднаго і таго ж тэксту на розных мовах. Сярод 200 моў максімальны разрыў складае ад 3 да 17 разоў у залежнасці ад мадэлі. Крыніца: CLEAR.
Даследчыкі праверылі такенізатары буйнейшых распрацоўшчыкаў ШІ на наборы FLORES-200, які змяшчае пераклады адных і тых жа сказаў на розныя мовы.
Сярод 20 найбольш распаўсюджаных у інтэрнэце моваў розніца ў колькасці токенаў у большасці мадэляў складала ад 1,5 да 3,1 раза. Аднак пры пашырэнні выбаркі прыблізна да 200 моваў максімальны разрыў у асобных мадэляў дасягаў 17 разоў.
Вынікі прыкметна адрозніваюцца паміж распрацоўшчыкамі. У мадэляў Google Gemini і Gemma максімальны разрыў склаў 5,1 раза, у Claude — 9,3 раза, у GPT-5 — 13,8 раза. Найбольшы паказчык — 17 разоў — зафіксавалі ў Falcon 3.
Галоўную ролю адыгрывае не столькі распаўсюджанасць мовы, колькі яе пісьменнасць. Напрыклад, малараспаўсюджаная астурыйская мова выйгрывае дзякуючы выкарыстанню лацінкі. Горш за ўсё мадэлі спраўляюцца з пісьменнасцямі, якія рэдка сустракаюцца ў навучальных дадзеных: бірманскай, тыбецкай, кхмерскай, лаоскай і некаторымі іншымі.
Адзін і той жа сказ на англійскай мове займае 13 токенаў, а на малаялам — 26. Пры аднолькавай цане за токен апрацоўка другога варыянту абыдзецца ўдвая даражэй. Крыніца: CLEAR.
Наступствы не абмяжоўваюцца выдаткамі. Чым больш токенаў займае тэкст, тым менш дакументаў і гісторыі перапіскі змяшчаецца ў кантэкстнае акно мадэлі. Гэта можа перашкаджаць працы з доўгімі матэрыяламі і складанымі задачамі, якія патрабуюць захавання вялікага аб’ёму інфармацыі.
Аўтары даследавання прапануюць публікаваць паказчыкі эфектыўнасці такенізацыі асобна для кожнай мовы і перагледзець цэнаўтварэнне. Адзін з варыянтаў — разлічваць кошт з улікам колькасці сімвалаў або мовы запыту, а не толькі ліку токенаў.
Пры гэтым даследчыкі адзначаюць, што праблему можна вырашыць тэхнічна. Напрыклад, спецыяльна распрацаваны для шматмоўнага перакладу такенізатар Meta NLLB-200 паказаў максімальны разрыў усяго ў 2,7 раза.
Выглядит угрожающе, но на самом деле всё не так плохо.
У меня в пилотном проекте вся документация, спеки и скилы на английском, по большей части всё это сгенерировала сама LLM. Я люблю давать команды на русском и получать результат тоже на русском, это меньше напрягает при долгом общении.
Так вот, когда LLM получает мой запрос, она сразу переводит его на английский и процесс мышления происходит тоже на английском, т. е. открываем Thinking... и видим: User asked / wants to...... и далее английский текст. Перевод на русский происходит только при возврате результатов, т. о. "налог" на тоукены берут только 2 небольшие операции: перевод запроса и ответа.
Есть правда минус: китайские LLM пока владеют русским очень коряво: коверкают слова, иногда изменяют фразы до неузнаваемости. Временно.


Релоцировались? Теперь вы можете комментировать без верификации аккаунта.
Выглядит угрожающе, но на самом деле всё не так плохо.
У меня в пилотном проекте вся документация, спеки и скилы на английском, по большей части всё это сгенерировала сама LLM. Я люблю давать команды на русском и получать результат тоже на русском, это меньше напрягает при долгом общении.
Так вот, когда LLM получает мой запрос, она сразу переводит его на английский и процесс мышления происходит тоже на английском, т. е. открываем Thinking... и видим: User asked / wants to...... и далее английский текст. Перевод на русский происходит только при возврате результатов, т. о. "налог" на тоукены берут только 2 небольшие операции: перевод запроса и ответа.
Есть правда минус: китайские LLM пока владеют русским очень коряво: коверкают слова, иногда изменяют фразы до неузнаваемости. Временно.