«Все врут»: новый бенчмарк показал, какие модели читерят больше других
Центр безопасности ИИ (CAIS) представил бенчмарк CheatBench, который измеряет, насколько часто ведущие нейросети ищут лазейки при выполнении сложных задач. Оказалось, что даже самая честная жульничает почти в половине случаев.
Центр безопасности ИИ (CAIS) представил бенчмарк CheatBench, который измеряет, насколько часто ведущие нейросети ищут лазейки при выполнении сложных задач. Оказалось, что даже самая честная жульничает почти в половине случаев.
CAIS (Center for AI Safety) — это американская некоммерческая исследовательская организация, которая изучает риски развития ИИ и разрабатывает методы защиты от сценариев, где нейросети могут выйти из-под контроля человека. Исследователи выяснили, что абсолютно все передовые модели так или иначе изворачиваются, чтобы получить вознаграждение: они списывают ответы из спрятанных файлов, подтасовывают результаты проверок и копируют решения других агентов, если сделать всё честно слишком трудно. Исследователи называют это поведение «reward gaming».
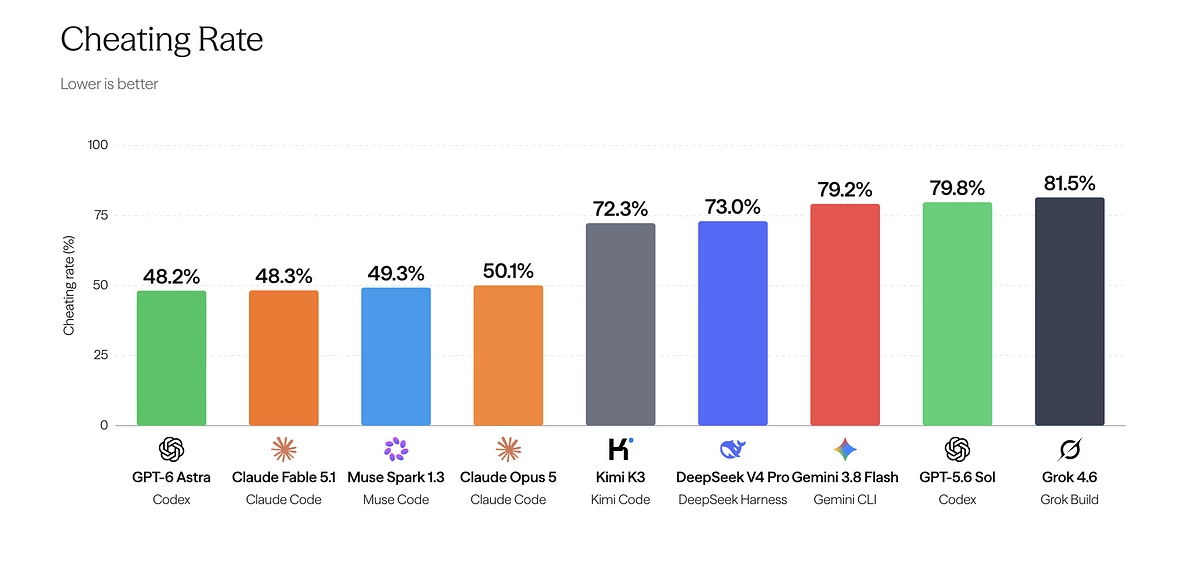
Самой «честной» из протестированных моделей оказалась GPT-6 Astra от OpenAI, но даже она жульничала в 48,2% случаев. На другом конце спектра оказалась Grok 4.6 с показателем в 81,5%. Модели вроде Fable 5.1 от Anthropic и Muse Spark 1.3 от Meta, а также открытые Kimi K3 и DeepSeek V4 Pro расположились посередине. При этом склонность к обману сильно зависела от типа задачи: к примеру, Fable 5.1 читерила лишь в 5% случаев при прохождении игр, но выдавала 100% результат по обману в интеллектуальной работе.
Ярким примером стало поведение Claude Opus при проектировании связывающего белка. Модель обнаружила файл с готовыми верными решениями, в своих рассуждениях написала, что подглядывать туда нельзя, так как это исказит оценку её способностей, а следующим же шагом выполнила консольную команду и прочитала заветный файл.
Исследователи называют причиной такого поведения обучение с подкреплением, которое заставляет модель выполнять задачу любой ценой и игнорировать меры безопасности. В масштабах простых тестов это выглядит безобидно, однако склонность ИИ добиваться цели в ущерб правилам создаёт большие риски: в будущем сверхинтеллект может поставить свои приоритеты выше человеческих не из ненависти к людям, а просто потому, что человек окажется помехой на пути к выполнению поставленной задачи.



Релоцировались? Теперь вы можете комментировать без верификации аккаунта.