ИИ-агенты работают до 66% лучше, если им периодически чистить память
ИИ-агенты могут работать эффективнее, если периодически очищать историю их переписки. Исследователи Microsoft обнаружили, что накопленный контекст мешает моделям искать новые решения, заставляя их снова и снова возвращаться к одним и тем же идеям.
ИИ-агенты могут работать эффективнее, если периодически очищать историю их переписки. Исследователи Microsoft обнаружили, что накопленный контекст мешает моделям искать новые решения, заставляя их снова и снова возвращаться к одним и тем же идеям.
Ученые изучили работу ИИ-агентов, которые самостоятельно предлагают решения сложных задач, проверяют их и пытаются улучшить. Оказалось, что даже при одинаковых условиях результаты восьми независимых запусков существенно различались — от 68,3 до 100 баллов. Дополнительные вычисления не всегда помогали агентам улучшить результат.
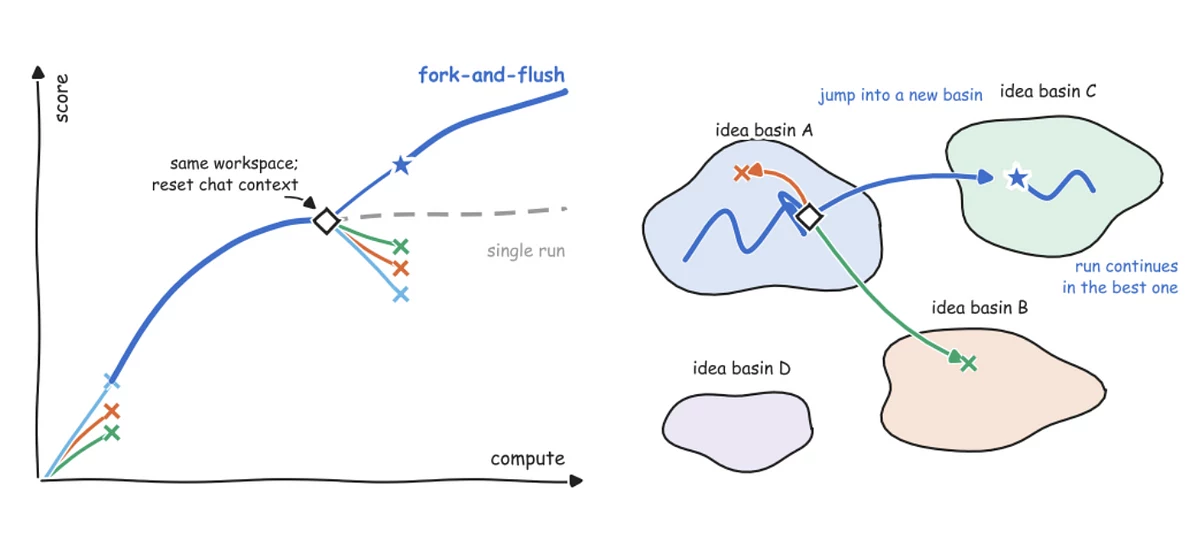
Исследователи назвали эту проблему «ловушками идей» (idea basins). Модель находит определенный подход и продолжает его совершенствовать, вместо того чтобы попробовать что-то принципиально новое. Даже сжатие истории переписки не решало проблему: прежние рассуждения продолжали влиять на следующие шаги.
Схема работы метода Fork-and-Flush: сравнение обычного запуска ИИ-агента с созданием параллельных веток, в которых история чата очищается, но рабочие файлы сохраняются. Справа показано, как это помогает агенту исследовать новые подходы к решению задачи. Источник: Cai, Ziakas et al. (2026).
Для ее решения Microsoft разработала метод Fork-and-Flush. Агент создает несколько параллельных копий, каждая из которых сохраняет рабочие файлы и результаты предыдущей работы, но начинает с чистой историей чата. Затем система выбирает наиболее успешную ветку.
Метод проверили на 13 сложных задачах, включая криптоанализ, математическую оптимизацию и работу с кодом. Использовались GPT-5.6 Terra и GPT-5.5 через GitHub Copilot CLI. При одинаковом вычислительном бюджете средняя оценка выросла на 66% — с 0,47 до 0,78. Метод показал лучший средний результат в 12 из 13 задач. Для сравнения: выбор лучшего результата из четырех независимых запусков дал оценку 0,54.
Даже простая очистка истории без создания параллельных агентов улучшила результаты примерно на 22% в отдельном сравнении на 11 задачах.



Релоцировались? Теперь вы можете комментировать без верификации аккаунта.