Не знаешь английский? Запросы к ИИ на других языках обходятся в разы дороже
Стоимость работы с ИИ зависит не только от модели, но и от языка запроса. Некоторые языки требуют значительно больше токенов, что увеличивает расходы и сокращает объем информации, доступной для обработки.
Стоимость работы с ИИ зависит не только от модели, но и от языка запроса. Некоторые языки требуют значительно больше токенов, что увеличивает расходы и сокращает объем информации, доступной для обработки.
К такому выводу пришли исследователи сообщества Coalition for Language Equity in AI Research (CLEAR), которые сравнили обработку текстов примерно на 200 языках. Разницу они назвали скрытым «налогом на токены».
Проблема связана с токенизацией — процессом, при котором ИИ разбивает текст на небольшие фрагменты перед обработкой. Токен может соответствовать целому слову, его части или даже отдельному байту. Чем менее эффективно модель обрабатывает язык, тем больше токенов требуется для передачи одного и того же смысла.
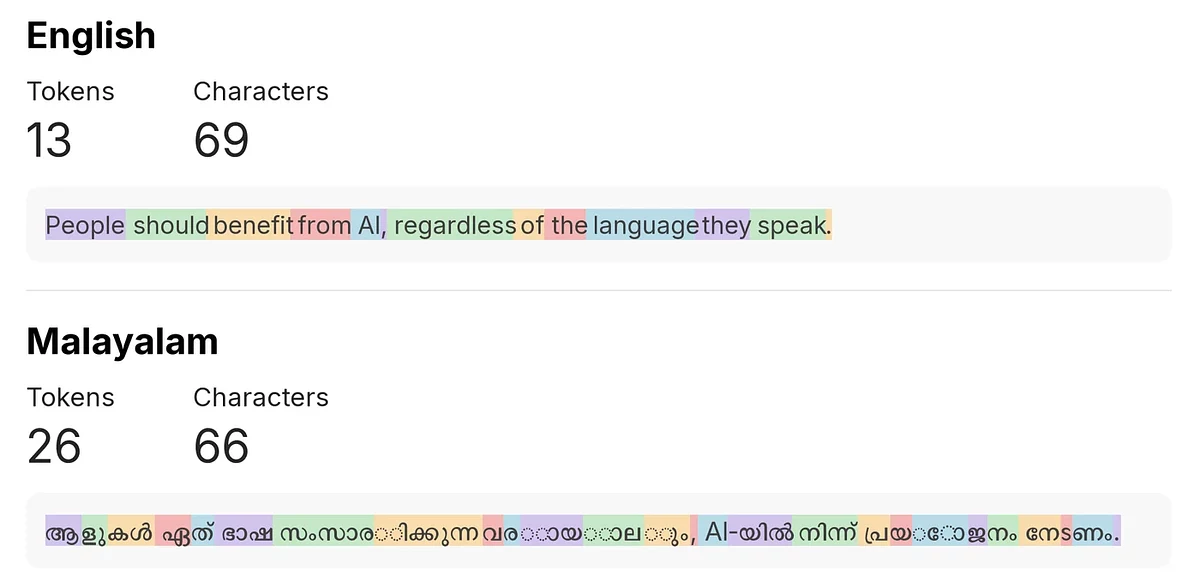
Например, фраза «Люди должны получать пользу от ИИ независимо от того, на каком языке они говорят» на английском занимает в GPT-5 всего 13 токенов. Ее перевод на язык жителей Индии малаялам требует 26 токенов, а на амхарский (говорят в Эфиопии) — уже 78. Таким образом, последний вариант обходится в шесть раз дороже при оплате входных токенов по одинаковому тарифу.
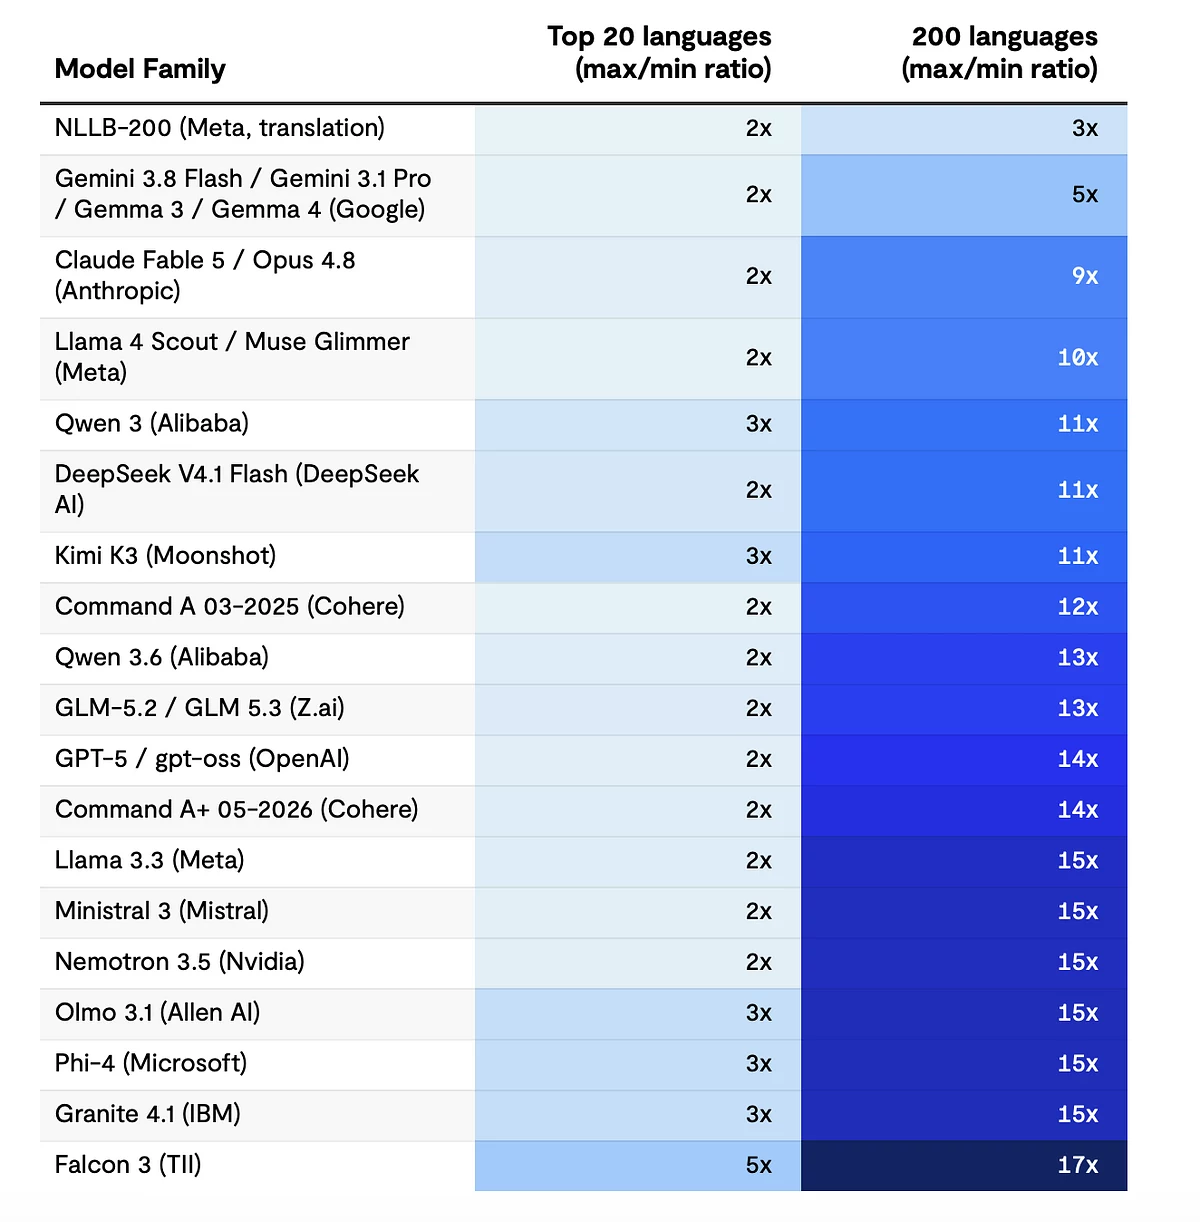
Разница в количестве токенов для одного и того же текста на разных языках. Среди 200 языков максимальный разрыв составляет от 3 до 17 раз в зависимости от модели. Источник: CLEAR.
Исследователи проверили токенизаторы крупнейших разработчиков ИИ на наборе FLORES-200, содержащем переводы одних и тех же предложений на разные языки.
Среди 20 наиболее распространенных в интернете языков разница в количестве токенов у большинства моделей составляла от 1,5 до 3,1 раза. Однако при расширении выборки примерно до 200 языков максимальный разрыв у отдельных моделей достигал 17 раз.
Результаты заметно различаются между разработчиками. У моделей Google Gemini и Gemma максимальный разрыв составил 5,1 раза, у Claude — 9,3 раза, у GPT-5 — 13,8 раза. Наибольший показатель — 17 раз — зафиксировали у Falcon 3.
Главную роль играет не столько распространенность языка, сколько его письменность. Например, малораспространенный астурийский язык выигрывает благодаря использованию латиницы. Хуже всего модели справляются с письменностями, которые редко встречаются в обучающих данных: бирманской, тибетской, кхмерской, лаосской и некоторыми другими.
Одно и то же предложение на английском языке занимает 13 токенов, а на малаялам — 26. При одинаковой цене за токен обработка второго варианта обойдется вдвое дороже. Источник: CLEAR.
Последствия не ограничиваются расходами. Чем больше токенов занимает текст, тем меньше документов и истории переписки помещается в контекстное окно модели. Это может мешать работе с длинными материалами и сложными задачами, требующими сохранения большого объема информации.
Авторы исследования предлагают публиковать показатели эффективности токенизации отдельно для каждого языка и пересмотреть ценообразование. Один из вариантов — рассчитывать стоимость с учетом количества символов или языка запроса, а не только числа токенов.
При этом исследователи отмечают, что проблему можно решить технически. Например, специально разработанный для многоязычного перевода токенизатор Meta NLLB-200 показал максимальный разрыв всего в 2,7 раза.
Выглядит угрожающе, но на самом деле всё не так плохо.
У меня в пилотном проекте вся документация, спеки и скилы на английском, по большей части всё это сгенерировала сама LLM. Я люблю давать команды на русском и получать результат тоже на русском, это меньше напрягает при долгом общении.
Так вот, когда LLM получает мой запрос, она сразу переводит его на английский и процесс мышления происходит тоже на английском, т. е. открываем Thinking... и видим: User asked / wants to...... и далее английский текст. Перевод на русский происходит только при возврате результатов, т. о. "налог" на тоукены берут только 2 небольшие операции: перевод запроса и ответа.
Есть правда минус: китайские LLM пока владеют русским очень коряво: коверкают слова, иногда изменяют фразы до неузнаваемости. Временно.


Релоцировались? Теперь вы можете комментировать без верификации аккаунта.
Выглядит угрожающе, но на самом деле всё не так плохо.
У меня в пилотном проекте вся документация, спеки и скилы на английском, по большей части всё это сгенерировала сама LLM. Я люблю давать команды на русском и получать результат тоже на русском, это меньше напрягает при долгом общении.
Так вот, когда LLM получает мой запрос, она сразу переводит его на английский и процесс мышления происходит тоже на английском, т. е. открываем Thinking... и видим: User asked / wants to...... и далее английский текст. Перевод на русский происходит только при возврате результатов, т. о. "налог" на тоукены берут только 2 небольшие операции: перевод запроса и ответа.
Есть правда минус: китайские LLM пока владеют русским очень коряво: коверкают слова, иногда изменяют фразы до неузнаваемости. Временно.